Локальная нейросеть без видеокарты: что реально можно запустить на обычном процессоре
Разбираем, какие квантованные LLM и function-calling модели реально работают на CPU: сколько нужно RAM, какие скорости ждать, как запускать через llama.cpp и Ollama, где это полезно и когда без GPU не обойтись.
Почему CPU inference снова актуален
Ещё недавно локальные нейросети ассоциировались только с дискретной видеокартой. Ситуация изменилась: появились компактные модели на 1–8 млрд параметров, а квантование в формате GGUF снизило требования к памяти в разы. Теперь даже офисный ПК или мини-ПК запускает чат-модель, извлекает данные из текста и выполняет простую автоматизацию — без GPU. Границы возможностей: CPU не заменит видеокарту для тяжёлых моделей и больших контекстов, но для узких задач даёт автономность, нулевую стоимость инференса и полный контроль над данными.
Что значит «без видеокарты»: типичные конфигурации
Под «без видеокарты» обычно подразумевают встроенную графику (iGPU) или её отсутствие в расчёте. Ключевые ресурсы для CPU inference — оперативная память и её пропускная способность, а не вычислительные блоки видеокарты. Типичные варианты: офисный ПК на 4–8 ядрах с 8–16 ГБ RAM, домашний мини-ПК на 16 ГБ, ноутбук на 16–32 ГБ. Все они запускают небольшие квантованные модели при правильном подборе размера.
| Конфигурация | RAM | Что реально запускать |
|---|---|---|
| Офисный ПК, 4 ядра | 8 ГБ | Модели 1–3B в Q4, классификация, извлечение данных |
| Домашний ПК, 6–8 ядер | 16 ГБ | Модели 3–8B в Q4, чат, function calling |
| Мини-ПК, 8 ядер | 16–32 ГБ | Модели 7–8B в Q4/Q5, автоматизация |
| Рабочая станция, 12+ ядер | 32–64 ГБ | Модели 13B в Q4, пакетная обработка |
Квантование: как оно позволяет запускать LLM на CPU
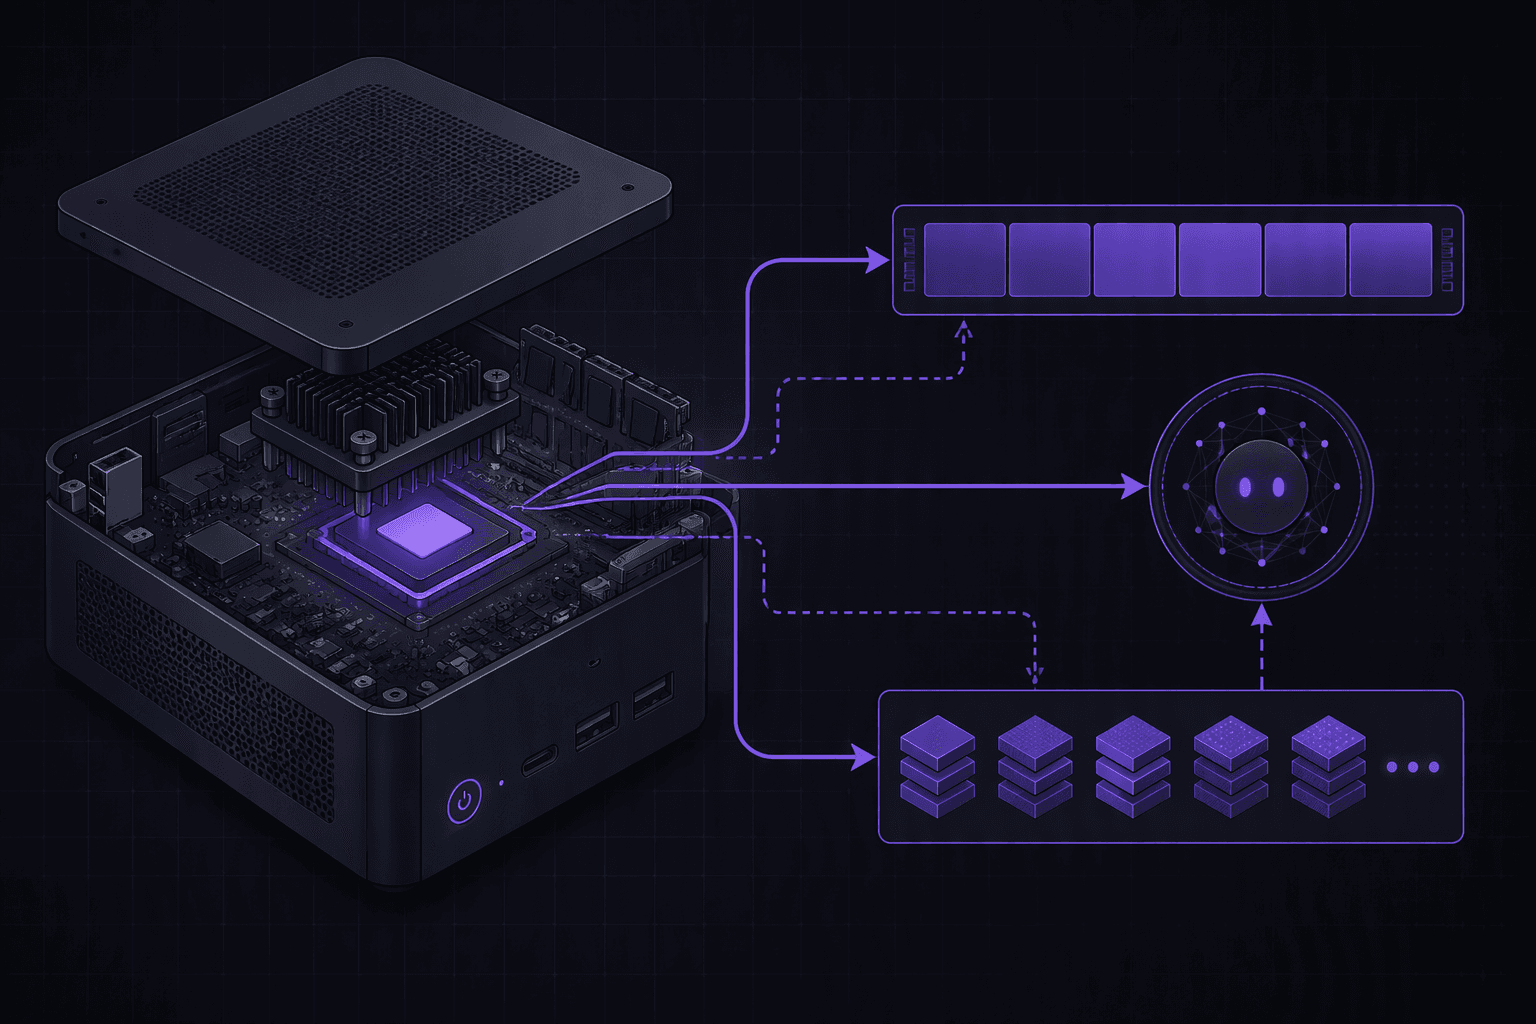
Квантование уменьшает точность весов модели (например, с 16 бит до 4 бит), снижая размер файла и требования к памяти. Формат GGUF — стандарт для CPU-инференса в llama.cpp и совместимых инструментах. Чем ниже битность, тем меньше RAM нужно, но тем выше риск деградации качества.
- Q8_0 — почти без потери качества, но самый большой размер;
- Q5_K_M — хороший баланс для 16 ГБ RAM;
- Q4_K_M — популярный компромисс для CPU;
- Q3_K_M и ниже — экономят память, но заметно теряют в качестве.
Сколько RAM нужно и какие модели влезают
Грубая формула: число параметров в миллиардах умножить на битность кванта и разделить на 8, плюс запас на контекст и служебные данные. На практике для 7–8B в Q4 достаточно 6–8 ГБ только под веса, но с учётом контекста и ОС лучше иметь 16 ГБ. Для 13B в Q4 нужно около 8–10 ГБ под веса, комфортно — 32 ГБ.
| Размер модели | Квант | RAM под веса | Комфортная RAM системы |
|---|---|---|---|
| 1–3B | Q4 | 1–2 ГБ | 8 ГБ |
| 7–8B | Q4 | 4–5 ГБ | 16 ГБ |
| 7–8B | Q8 | 8–9 ГБ | 16–32 ГБ |
| 13B | Q4 | 7–8 ГБ | 32 ГБ |
Скорость генерации на CPU: реалистичные цифры
Скорость зависит от числа ядер, поддержки AVX2/AVX-512 и пропускной способности памяти. На типичном 8-ядерном CPU модель 7–8B в Q4 выдаёт примерно 5–15 токенов в секунду, модели 1–3B — 20–40 токенов в секунду. Короткий ответ в 100–200 токенов занимает от нескольких секунд до полуминуты. Для интерактивного чата это терпимо, для потоковой генерации больших текстов — медленно.
Инструменты запуска: llama.cpp, Ollama, LM Studio
- llama.cpp — базовая библиотека для CPU-инференса, максимум контроля и настроек;
- Ollama — удобная обёртка с простым CLI и API, сама управляет моделями;
- LM Studio — графический интерфейс для загрузки GGUF и чата без командной строки;
- text-generation-webui — гибкий веб-интерфейс с поддержкой множества бэкендов.
# Пример запуска модели через llama.cpp
./llama-cli -m model-Q4_K_M.gguf -p "Привет!" -n 128 -t 8
Небольшие LLM для чата и текстовых задач
Для CPU разумно выбирать модели 1–8B. Среди популярных семейств — Qwen, Llama, Phi, Gemma и Mistral в младших размерах. Они подходят для перефразирования, суммаризации, ответов на вопросы по короткому контексту и черновиков текста. Чем меньше модель, тем быстрее ответ, но тем выше риск ошибок в сложных рассуждениях.
Function-calling модели на CPU: сценарии и подводные камни
Function calling позволяет модели возвращать структурированный вызов функции, например JSON с параметрами. На CPU это работает для небольших моделей, специально обученных этому, но есть нюансы: качество следует проверять на своих сценариях, а формат ответа — валидировать. Ошибки в JSON, галлюцинации в аргументах и нестабильность при длинном контексте — типичные проблемы.
- Определите чёткую схему функции с типами параметров;
- Ограничьте набор доступных функций;
- Валидируйте JSON перед выполнением;
- Предусмотрите fallback при ошибке парсинга.
Классификация, извлечение данных и автоматизация без GPU
Для классификации и извлечения сущностей часто достаточно моделей 1–3B или специализированных энкодеров. Они быстрее генеративных и стабильнее на узких задачах. Типичные сценарии: сортировка обращений, извлечение полей из писем, тегирование документов, простые правила автоматизации с участием LLM.
Разумные сценарии использования CPU inference
- Приватная обработка данных без отправки в облако;
- Автоматизация рутинных текстовых задач на одном ПК;
- Прототипирование перед покупкой GPU;
- Работа в офлайн-среде или там, где GPU недоступен;
- Пакетная обработка небольших объёмов текста.
Когда CPU недостаточно: честные ограничения
- Большие контексты (десятки тысяч токенов) — резкое падение скорости;
- Модели 30B+ — не влезают в разумную RAM и работают слишком медленно;
- Генерация изображений и видео — практически нереальна на CPU;
- Высокие требования к latency в реальном времени;
- Параллельная обработка множества запросов.
Итоги и рекомендации по выбору модели
Если у вас 8 ГБ RAM — смотрите на модели 1–3B в Q4 для классификации и извлечения данных. Для 16 ГБ оптимальны 7–8B в Q4_K_M: рабочий вариант для чата и function calling. При 32 ГБ можно попробовать 13B в Q4, но скорость будет скромной. Начинайте с Ollama или LM Studio, чтобы быстро оценить пригодность, и переходите на llama.cpp, когда нужен тонкий контроль.
Можно ли запустить нейросеть без видеокарты?
Да, небольшие квантованные модели (1–8B) работают на CPU. Потребуется достаточный объём RAM и терпимость к невысокой скорости генерации.
Сколько RAM нужно для локальной нейросети на CPU?
Для 1–3B в Q4 достаточно 8 ГБ, для 7–8B в Q4 — около 16 ГБ, для 13B в Q4 — 32 ГБ с запасом.
llama.cpp или Ollama — что выбрать на CPU?
Ollama проще для старта и управления моделями, llama.cpp даёт больше контроля и настроек. Оба работают на CPU с GGUF.
Подходит ли CPU для function calling?
Да, для небольших моделей с поддержкой function calling, но нужно валидировать JSON и ограничивать набор функций.